一个七十五岁的美国老头,花了五十年时间干了一件事:把九万六千多个古代汉字字形,一个一个录进电脑。他叫理查德·西尔斯,中国网友更习惯叫他"汉字叔叔"。
2025年底的一次国际语言文化研讨会上,老爷子用他那口怪腔怪调的中文,当着全场的面扔出一个炸弹——"汉字,是全球唯一超越时空的文字。"
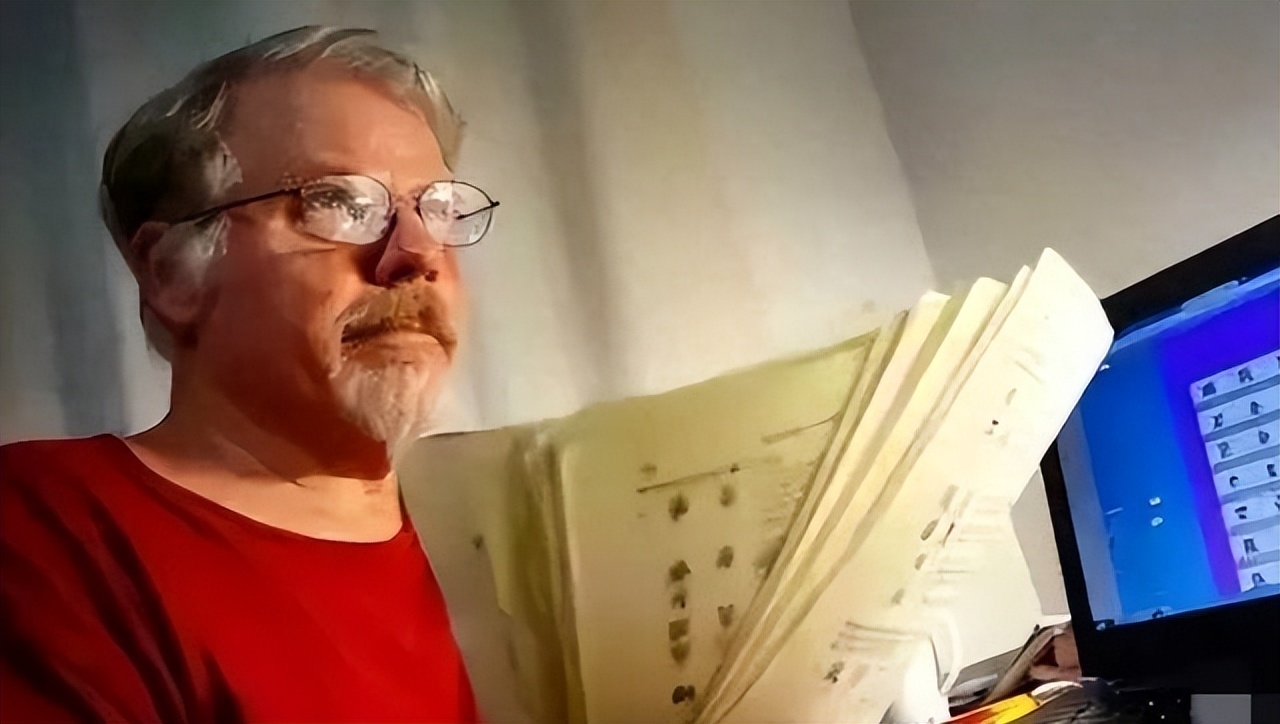
说实话,这种话要是中国人自己说,估计评论区立刻就有人喷"文化自嗨"。但从一个把半辈子搭进去研究汉字、在南京设立了工作室,尝试用动画、增强现实和人工智能等新技术制作短视频来讲述汉字故事的美国学者嘴里说出来,味道就完全不一样了。
他到底凭什么下这个结论?这事还真不是嘴炮,背后全是硬数据。
先说一个最直观的例子。联合国有六种官方语言,同一份《联合国宪章》翻成六个版本,厚薄差距大到离谱。
中文版大约两万六千多字,英文版五万五千多字,法文版、俄文版、西班牙文版都在五六万字上下,连阿拉伯文版都超过四万字。说白了,中文用一半的篇幅就把同样的内容说完了,而且一个字都没少。
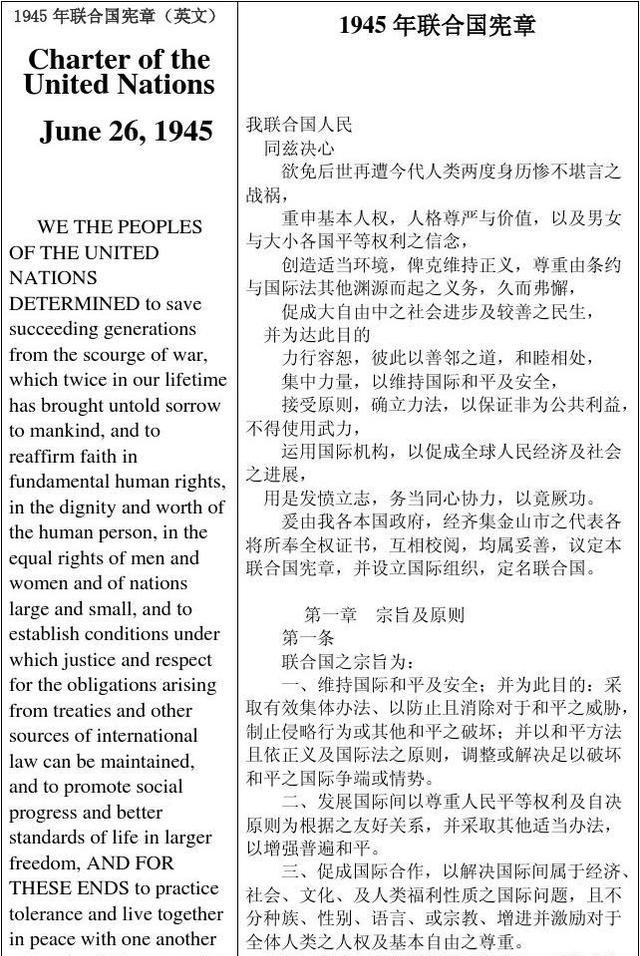
更夸张的是词汇量的对比——中文版只用了四百多个不同的词汇,英文版用了九千多个,法文版接近一万个,西班牙文版更是突破了一万。同一份文件,中文的词汇量只有其他语言的几十分之一。
这不是巧合,是汉字底层设计决定的。语言学上有个概念叫"信息熵",通俗理解就是每个字符所承载的信息量。汉字的单字平均信息熵高达9.6比特,而英语字母大约4比特,法语3.98比特,西班牙语4.01比特。
也就是说,一个汉字顶两个多英文字母的信息量。针对中文无空格特性,DeepSeek开发了基于上下文感知的智能分词系统,在古文、网络用语等特殊场景下,分词准确率提升至98.3%——连AI都在利用汉字这个天然的"高压缩"特性做文章。
西尔斯在演讲里拿吃肉举例子,特别形象:英语里牛是cow,牛肉是beef,羊肉是mutton,猪肉是pork,四个完全不相干的词,你得一个个死记。
中国人呢?认识"牛""羊""猪""肉"四个字就够了,牛肉、羊肉、猪肉,排列组合,触类旁通。英文是每碰到一个新东西就造一个新零件,而汉字是拿有限的积木块搭出无限可能。
《牛津英语大词典》收录了四十多万个单词,每年还在疯狂膨胀。可《新华字典》常用汉字才三千五百个左右,掌握这些字就能读懂百分之九十八的书面材料。这笔账谁都算得清:学习成本低、使用效率高、组合能力强——汉字就是天生的"信息压缩包"。
效率高还不是汉字最狠的地方。真正让西尔斯说出"超越时空"这四个字的,是汉字那个逆天的穿越能力。
研讨会上他做了一个实验。他翻出一块甲骨文拓片,上面刻着"癸卯卜,今日雨"——三千多年前商朝人占卜留下的记录。台下一个中国观众站起来,脱口而出:"癸卯日占卜,今天会下雨。"没有查字典,没有翻译,直接就读懂了。
然后西尔斯翻出另一张照片,是古英语史诗《贝奥武夫》的手稿,写于公元八世纪到十世纪。他问在场的英国人:谁能直接看懂?全场没一个人吭声。这部作品比那块甲骨还晚了两千多年,但现在的英国人必须靠专业翻译才能读。
四百年前莎士比亚的英语,现在美国高中生已经需要大量注释才能啃下来。再往前推到十四世纪乔叟的《坎特伯雷故事集》,对现在的英语母语者来说,跟外语差不多了。语言学家布龙菲尔德说得更直白:九世纪阿尔弗雷德大帝时代的英语,对现代人来说就是外国语。
原因其实不复杂。英文是拼音文字,记录的是声音,而声音是语言中最不稳定的部分,几百年一变、几十年一小变。拼写跟着语音跑,跑着跑着就面目全非了。
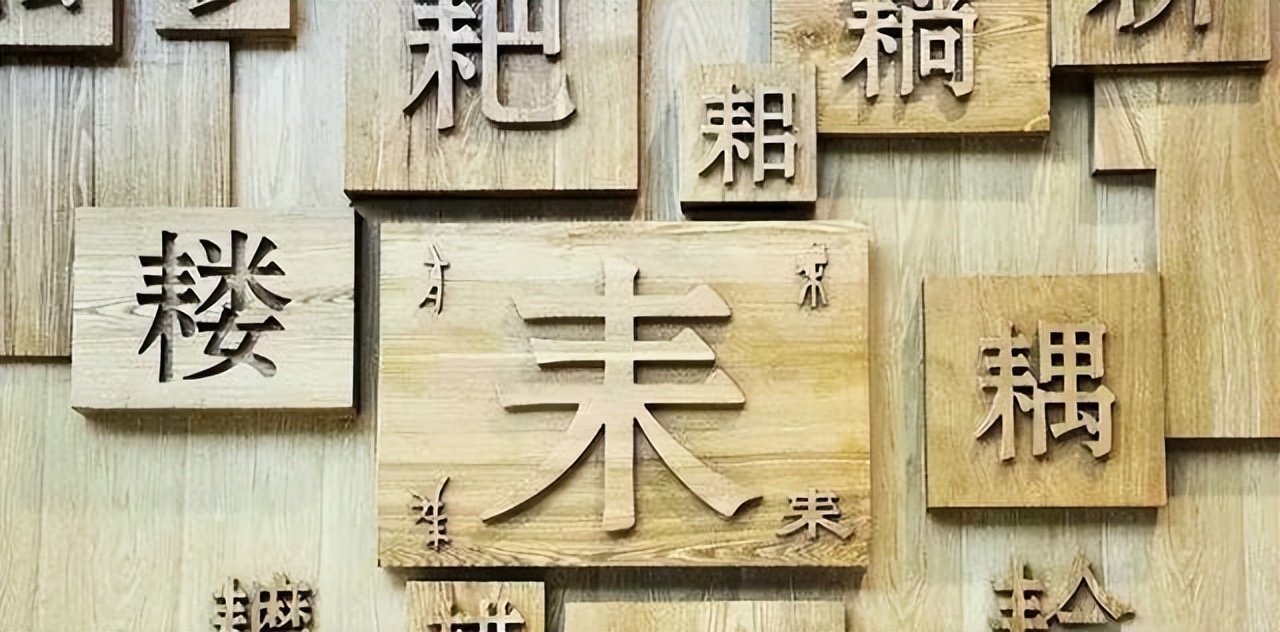
但汉字走的是另一条路。西尔斯的"汉字字源"网站对六千五百多个最常用的现代中文字进行了字源分析,收集编列超过九万六千个古代中文字形。
他在逐字追溯的过程中发现,汉字虽然经历了甲骨文、金文、小篆、隶书、楷书好几轮外观大改,但核心的意义指向从来没有断过。"雨"字从三千年前到今天,不管字形怎么变,"天上掉水"那个画面感一直都在。
2026年1月,《光明日报》有篇文章把这事讲得很到位:汉字以其形体结构的稳定性、直观性和象征性,有效突破了地域方言的隔阂与历史时空的距离。
打个不太严谨的比方——西方人想读四百年前祖先的文献,得先"破译密码";中国人翻开三千年前的甲骨文,虽然有些字不认识了,但那些核心字的意思,跟今天写在课本上的没什么两样。
这种文化传承的连续性,放眼全世界真找不出第二个。古巴比伦楔形文字、古埃及象形文字早就断了香火,只有汉字从未失传,一路活到了今天。
如果说以上这些还只是历史和语言学层面的事,那接下来的故事,大概会让更多人感到意外——汉字的优势,正在AI时代被成倍放大。
2025年初,DeepSeek横空出世,震动全球科技圈。其V3模型在多项第三方评测中表现强劲,在一致性、推理能力等维度均优于海外的主流模型;与此同时,其训练成本远低于同类产品。
更重要的是,DeepSeek从训练阶段就特别强化了中文语料,优化了对中文的理解能力,使其能更流畅地生成自然、符合语境的中文文本。
通过"千字文"式分词算法,DeepSeek能够更好地理解成语、典故等中文特有的语言现象。中文语料信息密度高、冗余度低的天然属性,某种程度上正是这款模型能以极低成本实现顶尖性能的关键之一。
斯坦福大学发布的《2026年人工智能指数报告》显示,中美AI模型性能差距已基本消失。2025年2月DeepSeek-R1短暂追平美国顶尖模型,截至2026年3月美国领先优势仅剩2.7%。
中国在论文发表数量、论文被引频次、专利产出总量以及工业机器人安装量等多项指标上已占据优势。AI赛道上,中国跑出了自己的节奏,而汉字体系的高效率,正是这场技术突围中一个容易被忽视却至关重要的底层变量。
与此同时,全球"中文热"也在持续升温。目前全球中文学习者和使用者累计超2亿人,中文已被86个国家纳入国民教育体系。2025年底,HSK3.0在全球部分考点启动试行,覆盖亚洲、欧洲、美洲、非洲及大洋洲地区,全球168个国家均设有考点。
2024年全年共为超过81万名考生提供考试服务,考生数量创历史新高,其中非洲中文水平考试考量同比增长36%。连太空都不例外——中国空间站的操作界面全部使用中文,欧洲航天员为了有朝一日登上中国空间站,早已开始拼命学中文,有人甚至给自己取了中文名字。
说到底,西尔斯这个美国人穷尽半生研究汉字,最后用四个字概括他的发现——"超越时空"。这不是一个煽情的比喻,而是可以用信息熵验证、用联合国文件丈量、用AI训练成本计算的客观事实。
汉字不是挂在博物馆里的古董符号,它是一套五千年前就写好的底层代码,经过无数次界面升级,内核一个字没改。在英语、法语、俄语都需要不断给自己打"翻译补丁"的时候,汉字依然稳稳地跑在那条从殷商直通未来的高速公路上。
景盛配资提示:文章来自网络,不代表本站观点。